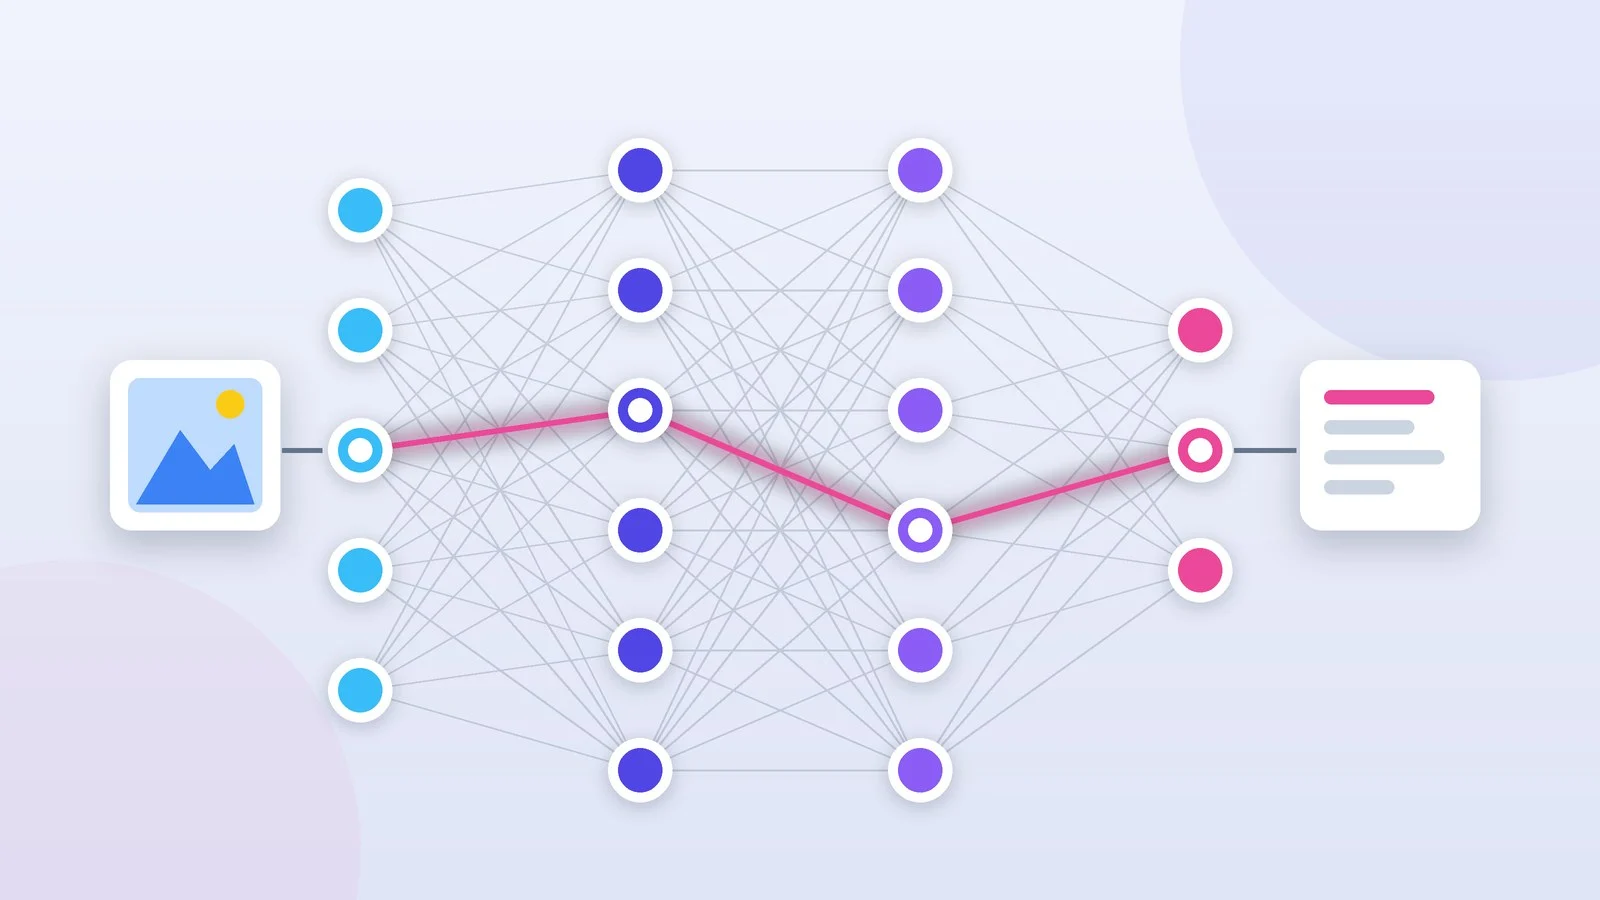
Нейронні мережі — це моделі машинного навчання, які навчаються на прикладах, а не виконують заздалегідь написані правила. Така мережа складається з безлічі простих обчислювальних вузлів — штучних нейронів, з’єднаних шарами, — а все, чого вона навчилася, зберігається в числах: вагах зв’язків між нейронами.
Нижче — як нейромережа влаштована й як навчається (без формул), чим відрізняються повнозв’язні, згорткові, рекурентні мережі й трансформери, як із ними пов’язані ChatGPT та інші великі мовні моделі, де ви користуєтеся нейромережами щодня і які в них обмеження. Наприкінці — коротка історія, словничок термінів і відповіді на часті запитання.
Нейромережа простими словами
Звичайну програму пише людина: вона задає правила на кшталт «якщо на фото вуса й гострі вуха — це кіт». На реальних знімках такі правила ламаються: кіт може сидіти спиною, у темряві або наполовину за диваном. Нейромережу навчають інакше: їй показують тисячі фотографій із підписами «кіт» і «не кіт», і вона сама знаходить ознаки, за якими їх розрізняти.
Назва — данина біології: ідею надихнула будова мозку, де нейрони пов’язані синапсами, які можуть посилюватися й слабшати. У штучній мережі роль синапсів відіграють ваги. Але штучний нейрон — це не клітина, а проста математична операція, і «думає» мережа зовсім не так, як людина.
Нейромережі — один із методів машинного навчання, а машинне навчання — частина штучного інтелекту. Мережу, у якій більше одного прихованого шару, називають глибокою, звідси термін «глибинне навчання». Великі мовні моделі, на яких працюють ChatGPT, Gemini і Claude, — теж глибокі нейромережі, тільки дуже великі.
Як працюють нейронні мережі
Нейрон: зважити, скласти, вирішити
Кожен штучний нейрон робить три дії. Множить кожне вхідне число на свою вагу й підсумовує результати. Додає зсув — ще одне число, яке зміщує поріг спрацьовування. Пропускає суму через функцію активації: наприклад, популярна функція ReLU замінює від’ємні значення нулем, а додатні залишає як є.
Ваги зручно уявляти як регулятори гучності: вони вирішують, наскільки сильно кожен вхідний сигнал впливає на результат. Функція активації потрібна, щоб мережа знаходила складні, нелінійні залежності. Без неї будь-яка кількість шарів зводилася б до однієї простої формули.
Шари: від пікселів до відповіді
Нейрони зібрані в шари: вхідний отримує дані, приховані їх перетворюють, вихідний видає відповідь. Класичний навчальний приклад — розпізнавання рукописних цифр із набору MNIST. Картинка 28×28 пікселів перетворюється на 784 вхідні числа, по одному на яскравість кожного пікселя, а у вихідному шарі 10 нейронів — по одному на кожну цифру від 0 до 9.
Що глибший шар, то складніші ознаки, на які він реагує. У мережах для зображень перші шари зазвичай відгукуються на краї та кольорові плями, а глибші — на цілі візерунки й частини предметів. Цих ознак мережу ніхто не вчить напряму: вони з’являються самі під час навчання.
Навчання: помилка і зворотне поширення
У нової мережі ваги випадкові, і її відповіді безглузді. Навчання — це той самий цикл, повторений на тисячах або мільйонах прикладів із відомими правильними відповідями.
Прогноз
Мережа отримує приклад і видає відповідь
Помилка
Функція втрат порівнює відповідь із правильною
Зворотне поширення
Алгоритм рахує, як кожна вага вплинула на помилку
Коригування ваг
Ваги зсуваються на невеликий крок у бік меншої помилки
Функція втрат (loss) — мірило помилки: що далі відповідь від правильної, то більше число. Зворотне поширення помилки (backpropagation) іде від виходу мережі до входу й для кожної ваги обчислює, як вона вплинула на помилку і в який бік її зсунути. Сам зсув називають кроком градієнтного спуску: це як спускатися з гори в тумані, щоразу ступаючи туди, де схил іде вниз.
Один повний прохід усіма навчальними прикладами називають епохою. Готову мережу перевіряють на прикладах, яких вона не бачила під час навчання. Якщо на знайомих даних вона майже не помиляється, а на нових помиляється часто, отже, мережа перенавчилася: запам’ятала відповіді замість того, щоб уловити закономірність.
Основні види нейромереж і де їх застосовують
Архітектур нейромереж багато, але щоб розуміти, як влаштовані знайомі сервіси, достатньо чотирьох основних.
| Тип мережі | Як влаштована | Де застосовують |
|---|---|---|
| Повнозв’язна | Нейрон пов’язаний з усім наступним шаром | Таблиці, прогнози, блоки моделей |
| Згорткова (CNN) | Фільтри шукають візерунки на картинці | Фото, відео, медичні знімки |
| Рекурентна (RNN) | Читає покроково й пам’ятає минуле | Мовлення, часові ряди, датчики |
| Трансформер | Увага пов’язує всі частини входу | Чат-боти, переклад, пошук, фото |
Повнозв’язні мережі
Найпростіша схема — багатошаровий перцептрон: кожен нейрон одного шару з’єднаний з усіма нейронами наступного. Такі мережі підходять для табличних даних, наприклад для оцінки ціни квартири за площею, районом і поверхом, і працюють як блоки всередині складніших моделей, зокрема трансформерів.
Для зображень повнозв’язна схема невигідна. У кольорової картинки 200×200 пікселів кожен нейрон першого шару отримав би 120 000 ваг, а таких нейронів потрібно багато.
Згорткові мережі (CNN)
Згорткова мережа не роздивляється картинку цілком. Невеликі фільтри «ковзають» зображенням і шукають повторювані візерунки — краї, текстури, форми, — причому той самий фільтр працює в будь-якій частині кадру. Тому мережа впізнає кота і в центрі знімка, і в кутку, а ваг їй потрібно набагато менше, ніж повнозв’язній.
Згорткові мережі розпізнають обличчя й предмети на фото та допомагають аналізувати медичні знімки. У 2012 році згорткова мережа AlexNet виграла конкурс із розпізнавання зображень ImageNet: правильна відповідь не потрапила до п’яти її варіантів у 15,3% випадків, у найближчого суперника — у 26,2%.
Рекурентні мережі (RNN)
Рекурентна мережа обробляє послідовність по одному елементу — слово за словом або вимір за виміром — і зберігає «пам’ять» про те, що було раніше. Звичайні RNN швидко забувають початок довгої послідовності. Щоб упоратися з цим, у 1997 році було описано мережі LSTM («довга короткочасна пам’ять»).
На LSTM була побудована система нейронного перекладу, яку Google запустила в Google Перекладачі у 2016 році. У завданнях із текстом і мовленням рекурентні мережі відтоді здебільшого поступилися місцем трансформерам, але їх досі застосовують для послідовних даних — наприклад, часових рядів.
Трансформери
Трансформер запропонували дослідники Google у 2017 році в статті «Attention Is All You Need». Його головна ідея — механізм уваги: модель одразу дивиться на всі слова фрази й для кожного вирішує, які інші слова важливі для його значення. У фразі «дівчина заплела косу» увага пов’яже «косу» з «заплела», а у фразі «косар нагострив косу» — з «нагострив».
На відміну від рекурентної мережі трансформер обробляє всю послідовність паралельно, тому його швидше навчати на величезних обсягах даних. На трансформерах побудовані мовні моделі GPT, Gemini і Llama, а з 2020 року їх застосовують і до картинок: зображення ріжуть на невеликі квадрати й обробляють як послідовність «слів».
Є й інші архітектури. Наприклад, генеративні змагальні мережі (GAN) і дифузійні моделі вміють створювати нові зображення, а не лише розпізнавати готові.
Великі мовні моделі та їхній зв’язок із нейромережами
Велика мовна модель (LLM, large language model) — це глибока нейромережа, найчастіше трансформер, із мільярдами параметрів, навчена на величезних масивах тексту. Її базова навичка проста: за початком тексту передбачити наступний токен — слово або частину слова. Повторюючи цей крок знову і знову, модель пише відповіді, листи й код.
Навчання відбувається в кілька етапів. Спочатку попереднє навчання: модель читає величезний корпус текстів без розмітки й учиться їх продовжувати. Така «сира» модель ще погано виконує інструкції, тому її донавчають на прикладах діалогів і за допомогою RLHF — навчання з підкріпленням на основі відгуків людей: люди порівнюють варіанти відповідей, і модель учиться видавати ті, які оцінили вище.
Як швидко ростуть моделі, добре видно з кількості параметрів.
60 млн
AlexNet, 2012
параметрів, розпізнавання зображень
175 млрд
GPT-3, 2020
параметрів, мовна модель OpenAI
405 млрд
Llama 3.1 405B, 2024
параметрів, відкрита модель Meta
Джерело: Статті й блоги розробників: NeurIPS 2012, OpenAI, Meta
Llama 3.1 405B навчали на понад 15 трлн токенів за допомогою понад 16 тис. графічних прискорювачів Nvidia H100. Її контекстне вікно — 128 тис. токенів: стільки тексту (запит, файли, попереднє листування) модель ураховує одночасно. Усе, що у вікно не вмістилося, вона просто не бачить.
ChatGPT, Gemini і Claude — продукти, усередині яких працюють такі моделі. Крім самої моделі, у чат-ботах є пошук в інтернеті, робота з файлами та інші інструменти. Чим помічники відрізняються на практиці й який обрати, ми розібрали в порівнянні ChatGPT, Gemini і Claude.
Зв’язок простий: будь-яка LLM — нейромережа, але далеко не кожна нейромережа — LLM. Мережа, яка впізнає ваше обличчя у Face ID, не пише текстів, а суто текстова модель не бачить картинок. Сучасні моделі при цьому дедалі частіше мультимодальні: Gemini, наприклад, від початку навчали працювати з текстом, зображеннями, аудіо й відео.
Де нейромережі працюють щодня у 2026 році
У 2026 році нейромережі вбудовані у звичні сервіси, навіть якщо слово «ШІ» там ніде не написано. Кілька прикладів із даними самих компаній і регулятора:
- Розблокування за обличчям. У Face ID блок Neural Engine перетворює карту глибини обличчя на математичний опис, а окремі нейромережі захищають від спроб відкрити iPhone маскою. За даними Apple, імовірність, що телефон розблокує випадкова людина, — менше ніж 1 до 1 000 000.
- Переклад. Google Перекладач почав переходити на нейронний переклад у 2016 році: за даними Google, на кількох великих мовних парах помилок стало на 55–85% менше. На нейромережах працюють і голосові перекладачі.
- Пошта без спаму. За даними Google, фільтри Gmail затримують понад 99,9% спаму, фішингу та шкідливих листів. У 2019 році компанія повідомила, що моделі на TensorFlow додали до них ще близько 100 млн заблокованих листів на день.
- Затори й час у дорозі. Google Карти з 2020 року прогнозують час поїздки за допомогою графових нейромереж DeepMind. За даними компанії, у Берліні, Токіо, Сіднеї та низці інших міст прогноз став точнішим — до 50%.
- Рекомендації. Ще у 2016 році Google описала, як рекомендації YouTube будують дві глибокі нейромережі: одна відбирає ролики-кандидати з величезного каталогу, інша їх ранжує.
- Пошук і чат-боти. Огляди від ШІ в Пошуку Google із травня 2025 року доступні в понад 200 країнах і територіях і більш ніж 40 мовами. ChatGPT, Gemini і Claude відповідають на запитання, пишуть тексти й код.
- Картинки й музика. Генеративні нейромережі створюють зображення й треки за текстовим описом — наприклад, музику в Suno, Udio і Adobe Firefly.
- Медицина. У публічному списку американського регулятора FDA — понад 1 600 медичних пристроїв і програм зі ШІ, дозволених до продажу в США (дані до кінця червня 2026 року). Близько трьох чвертей із них належать до радіології, тобто працюють зі знімками.
Обмеження: помилки, дані та енергія
Помилки й галюцинації
Нейромережа видає найімовірнішу відповідь, а не перевірену. У системи розпізнавання це виглядає як звичайна помилка: собаку сприйняли за кота. У мовних моделей — як галюцинація: упевнений і гладкий, але вигаданий факт, цитата чи посилання.
Дослідники OpenAI у статті 2025 року пояснюють це так: під час навчання й у тестах моделі заохочують за вгадану відповідь сильніше, ніж за чесне «не знаю», тому їм вигідніше вгадувати. За їхньою оцінкою, галюцинації лишаються навіть у найсучасніших систем.
Ціна помилки буває реальною. У червні 2023 року федеральний суд у Нью-Йорку оштрафував юристів на $5 000: вони подали документ із посиланнями на неіснуючі судові рішення, які вигадав ChatGPT (справа Mata v. Avianca).
Дані та упередженість
Нейромережа знає лише те, що було в навчальних даних, разом із їхніми перекосами. У дослідженні Gender Shades (MIT, 2018) три комерційні системи визначення статі за фото помилялися на світлошкірих чоловіках не частіше ніж у 0,8% випадків, а на темношкірих жінках — у 20,8–34,7% випадків.
Якщо даних мало або вони застаріли, модель помиляється частіше. Знання мовної моделі до того ж обмежені моментом, коли завершився збір текстів для її навчання: про пізніші події вона дізнається, лише якщо отримує їх через пошук в інтернеті або з ваших документів.
Нарешті, нейромережу важко перевірити зсередини. В Anthropic визнають, що моделі найчастіше сприймають як «чорну скриньку»: на вході запит, на виході відповідь, і незрозуміло, чому модель відповіла саме так. Розбором їхньої внутрішньої будови займається окремий напрям — інтерпретованість.
Енергія
Навчання й робота великих моделей потребують багато електрики. За оцінкою Міжнародного енергетичного агентства, у 2024 році центри обробки даних спожили близько 415 ТВт·год — приблизно 1,5% світової електроенергії. До 2030 року, за прогнозом агентства, їхнє споживання зросте більш ніж удвічі, приблизно до 945 ТВт·год, і головний рушій цього зростання — ШІ.
Окремий запит потребує небагато енергії. Google у серпні 2025 року повідомила, що медіанний текстовий запит до Gemini витрачає 0,24 Вт·год — як телевізор, увімкнений менш ніж на дев’ять секунд, — і що за 12 місяців цей показник знизився у 33 рази.
Коротка історія нейромереж
Нейромережам понад 80 років: ідея з’явилася задовго до смартфонів і чат-ботів.
1943
Модель нейрона
Воррен Маккалох і Волтер Піттс описали штучний нейрон математично
липень 1958
Перцептрон
Мережа Френка Розенблата на комп’ютері IBM 704 за 50 спроб навчилася розрізняти картки з позначкою ліворуч і праворуч
1986
Зворотне поширення помилки
Девід Румельгарт, Джефрі Гінтон і Рональд Вільямс показали в журналі Nature, як навчати багатошарові мережі
1997
LSTM
Описано рекурентні мережі з «довгою короткочасною пам’яттю»
2012
AlexNet
Згорткова мережа, навчена на відеокартах, виграла конкурс ImageNet
червень 2017
Трансформер
Дослідники Google опублікували статтю «Attention Is All You Need»
30 листопада 2022
ChatGPT
OpenAI відкрила чат-бот на основі моделі серії GPT-3.5
8 жовтня 2024
Нобелівська премія
Джонові Гопфілду і Джефрі Гінтону присудили премію з фізики за відкриття, які уможливили машинне навчання на нейромережах
Словничок: головні терміни
- Нейрон — вузол мережі: підсумовує входи, помножені на ваги, і пропускає суму через функцію активації.
- Вага — число, яке задає силу зв’язку між нейронами. Саме у вагах зберігається все, чого мережа навчилася.
- Функція активації — нелінійне перетворення, наприклад ReLU. Без нього мережа не вивчить складні залежності.
- Параметри — усі ваги й зсуви моделі. Їхню кількість зазвичай і називають розміром моделі.
- Функція втрат (loss) — формула, яка показує, наскільки відповідь мережі далека від правильної.
- Зворотне поширення помилки — спосіб порахувати, як кожна вага вплинула на помилку.
- Градієнтний спуск — покрокове підлаштування ваг у бік меншої помилки.
- Епоха — один повний прохід усіма навчальними прикладами.
- Перенавчання — мережа запам’ятала навчальні приклади, але погано працює на нових.
- Токен — шматочок тексту (слово, частина слова чи символ), з яким працює мовна модель.
- Контекстне вікно — скільки токенів модель ураховує за один раз, її «робоча пам’ять».
- Галюцинація — правдоподібна, але хибна відповідь моделі.
Джерела й методика
Аналіз відкритих джерелПеревірено 29 вересня 2026
- Google Machine Learning Crash Course: нейронні мережі developers.google.com
- Anthropic: глосарій термінів LLM (англійською) platform.claude.com
- Vaswani та ін. «Attention Is All You Need» (2017) arxiv.org
- OpenAI: Why language models hallucinate (2025) openai.com
- МЕА: Energy and AI (2025) iea.org
Часті запитання
Нейромережа і штучний інтелект — це одне й те саме?
Ні. Штучний інтелект — широка галузь, машинне навчання — її частина, а нейромережі — один із методів машинного навчання. Саме на нейромережах працюють ChatGPT, Gemini і Claude.
Нейромережа думає як людина?
Ні. Ідею нейромереж навіяла будова мозку, але штучний нейрон — проста математична операція. Мережа знаходить статистичні закономірності в даних і сама не перевіряє, чи правильна її відповідь.
Чим нейромережа відрізняється від звичайної програми?
Звичайну програму пише людина, задаючи правила. Нейромережа отримує приклади й сама підбирає ваги — у великих моделей їх мільярди, — тому впорується із завданнями, для яких правила не сформулювати, наприклад упізнає обличчя й мовлення.
Чому ChatGPT іноді вигадує факти?
Мовна модель передбачає правдоподібне продовження тексту, а не шукає істину. За даними OpenAI, під час навчання й у тестах моделі заохочують за вгадування сильніше, ніж за чесне «не знаю», тому галюцинації трапляються навіть у нових моделей.
Чи можна самому навчити нейромережу?
Так. Невелику мережу, наприклад для розпізнавання рукописних цифр MNIST, можна навчити на звичайному комп’ютері за допомогою безкоштовних бібліотек PyTorch або TensorFlow. Основи можна вивчити за безкоштовним курсом Google Machine Learning Crash Course.
Залишити відповідь