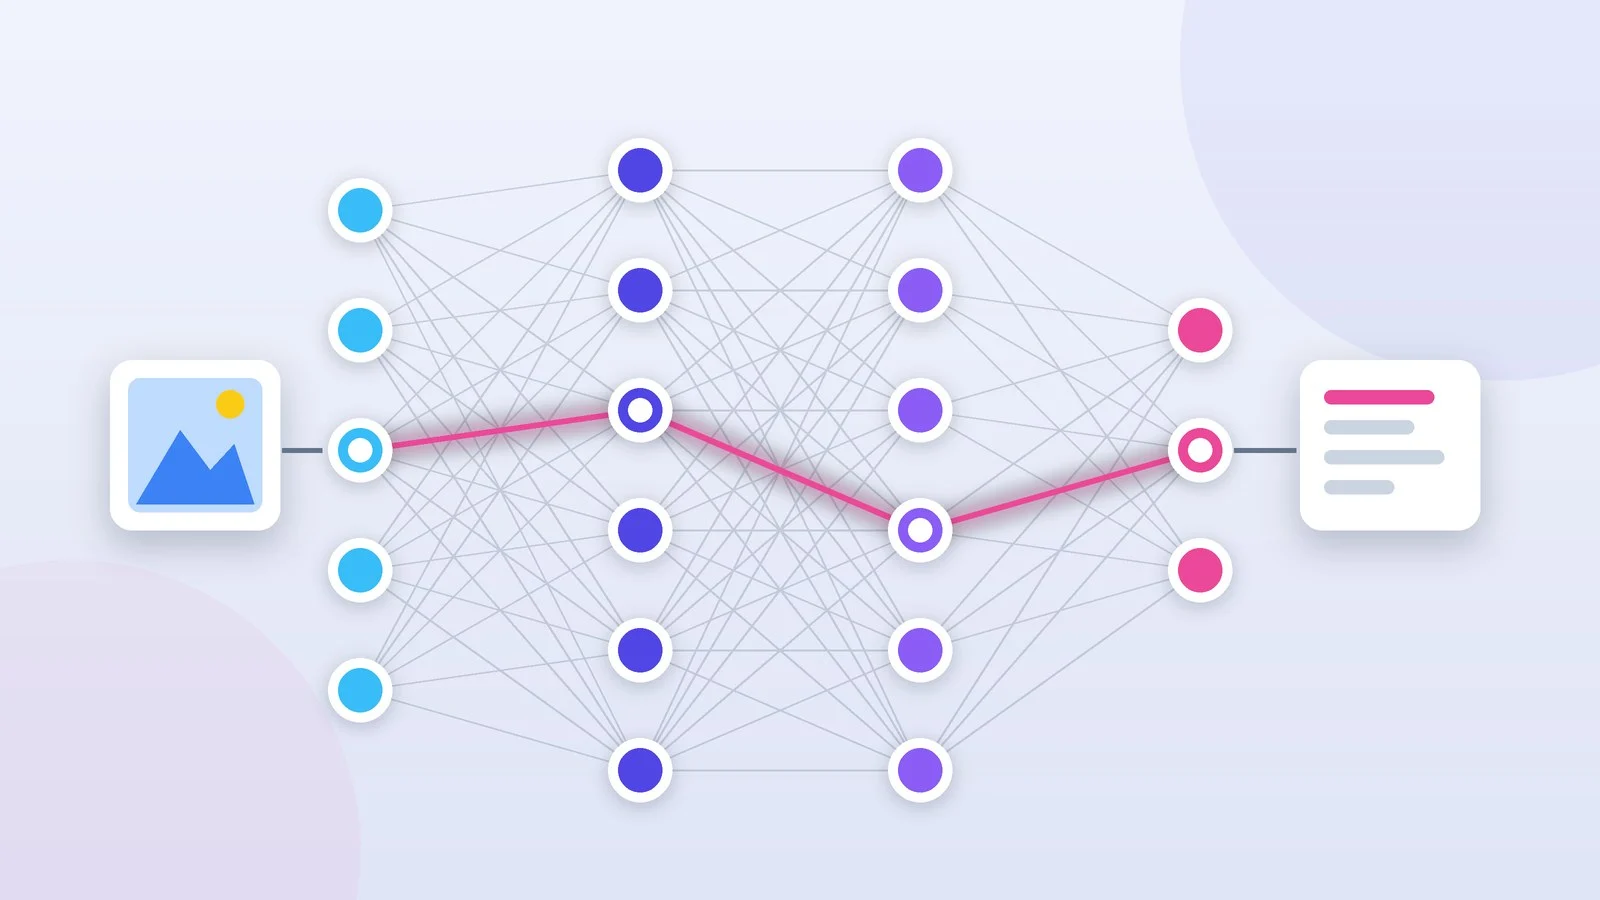
Нейронные сети — это модели машинного обучения, которые учатся на примерах, а не выполняют заранее написанные правила. Такая сеть состоит из множества простых вычислительных узлов — искусственных нейронов, соединённых слоями, — а всё, чему она научилась, хранится в числах: весах связей между нейронами.
Ниже — как нейросеть устроена и как обучается (без формул), чем отличаются полносвязные, свёрточные, рекуррентные сети и трансформеры, как с ними связаны ChatGPT и другие большие языковые модели, где вы пользуетесь нейросетями каждый день и в чём их ограничения. В конце — короткая история, словарик терминов и ответы на частые вопросы.
Нейросеть простыми словами
Обычную программу пишет человек: он задаёт правила вроде «если на фото усы и острые уши — это кошка». На реальных снимках такие правила ломаются: кошка может сидеть спиной, в темноте или наполовину за диваном. Нейросеть учат иначе: ей показывают тысячи фотографий с подписями «кошка» и «не кошка», и она сама находит признаки, по которым их различать.
Название — дань биологии: идею вдохновило устройство мозга, где нейроны связаны синапсами, которые могут усиливаться и ослабевать. В искусственной сети роль синапсов играют веса. Но искусственный нейрон — это не клетка, а простая математическая операция, и «думает» сеть совсем не так, как человек.
Нейросети — один из методов машинного обучения, а машинное обучение — часть искусственного интеллекта. Сеть, в которой больше одного скрытого слоя, называют глубокой, отсюда термин «глубокое обучение». Большие языковые модели, на которых работают ChatGPT, Gemini и Claude, — тоже глубокие нейросети, только очень большие.
Как работают нейронные сети
Нейрон: взвесить, сложить, решить
Каждый искусственный нейрон делает три действия. Умножает каждое входное число на свой вес и складывает результаты. Добавляет смещение — ещё одно число, которое сдвигает порог срабатывания. Пропускает сумму через функцию активации: например, популярная функция ReLU заменяет отрицательные значения нулём, а положительные оставляет как есть.
Веса удобно представлять как регуляторы громкости: они решают, насколько сильно каждый входной сигнал влияет на результат. Функция активации нужна, чтобы сеть находила сложные, нелинейные зависимости. Без неё любое количество слоёв сводилось бы к одной простой формуле.
Слои: от пикселей к ответу
Нейроны собраны в слои: входной получает данные, скрытые их преобразуют, выходной выдаёт ответ. Классический учебный пример — распознавание рукописных цифр из набора MNIST. Картинка 28×28 пикселей превращается в 784 входных числа, по одному на яркость каждого пикселя, а в выходном слое 10 нейронов — по одному на каждую цифру от 0 до 9.
Чем глубже слой, тем сложнее признаки, на которые он реагирует. В сетях для изображений первые слои обычно откликаются на края и цветовые пятна, а более глубокие — на целые узоры и части предметов. Этим признакам сеть никто не учит напрямую: они появляются сами в ходе обучения.
Обучение: ошибка и обратное распространение
У новой сети веса случайные, и её ответы бессмысленны. Обучение — это один и тот же цикл, повторённый на тысячах или миллионах примеров с известными правильными ответами.
Прогноз
Сеть получает пример и выдаёт ответ
Ошибка
Функция потерь сравнивает ответ с правильным
Обратное распространение
Алгоритм считает, как каждый вес повлиял на ошибку
Поправка весов
Веса сдвигаются на небольшой шаг в сторону меньшей ошибки
Функция потерь (loss) — мерило ошибки: чем дальше ответ от правильного, тем больше число. Обратное распространение ошибки (backpropagation) идёт от выхода сети ко входу и для каждого веса вычисляет, как он повлиял на ошибку и в какую сторону его сдвинуть. Сам сдвиг называют шагом градиентного спуска: это как спускаться с горы в тумане, каждый раз ступая туда, где склон идёт вниз.
Один полный проход по всем обучающим примерам называют эпохой. Готовую сеть проверяют на примерах, которых она не видела при обучении. Если на знакомых данных она почти не ошибается, а на новых ошибается часто, значит, сеть переобучилась: запомнила ответы вместо того, чтобы уловить закономерность.
Основные виды нейросетей и где их применяют
Архитектур нейросетей много, но чтобы понимать, как устроены знакомые сервисы, достаточно четырёх основных.
| Тип сети | Как устроена | Где применяют |
|---|---|---|
| Полносвязная | Нейрон связан со всем следующим слоем | Таблицы, прогнозы, блоки моделей |
| Свёрточная (CNN) | Фильтры ищут узоры по всей картинке | Фото, видео, медицинские снимки |
| Рекуррентная (RNN) | Читает по шагам и помнит прошлое | Речь, временные ряды, датчики |
| Трансформер | Внимание связывает все части входа | Чат-боты, перевод, поиск, фото |
Полносвязные сети
Самая простая схема — многослойный перцептрон: каждый нейрон одного слоя соединён со всеми нейронами следующего. Такие сети подходят для табличных данных, например для оценки цены квартиры по площади, району и этажу, и работают как блоки внутри более сложных моделей, включая трансформеры.
Для изображений полносвязная схема невыгодна. У цветной картинки 200×200 пикселей каждый нейрон первого слоя получил бы 120 000 весов, а таких нейронов нужно много.
Свёрточные сети (CNN)
Свёрточная сеть не разглядывает картинку целиком. Небольшие фильтры «скользят» по изображению и ищут повторяющиеся узоры — края, текстуры, формы, — причём один и тот же фильтр работает в любой части кадра. Поэтому сеть узнаёт кошку и в центре снимка, и в углу, а весов ей нужно гораздо меньше, чем полносвязной.
Свёрточные сети распознают лица и предметы на фото и помогают анализировать медицинские снимки. В 2012 году свёрточная сеть AlexNet выиграла конкурс по распознаванию изображений ImageNet: правильный ответ не попал в пять её вариантов в 15,3% случаев, у ближайшего соперника — в 26,2%.
Рекуррентные сети (RNN)
Рекуррентная сеть обрабатывает последовательность по одному элементу — слово за словом или замер за замером — и хранит «память» о том, что было раньше. Обычные RNN быстро забывают начало длинной последовательности. Чтобы справиться с этим, в 1997 году были описаны сети LSTM («долгая краткосрочная память»).
На LSTM была построена система нейронного перевода, которую Google запустила в Google Переводчике в 2016 году. В задачах с текстом и речью рекуррентные сети с тех пор в основном уступили место трансформерам, но их по-прежнему применяют для последовательных данных — например, временных рядов.
Трансформеры
Трансформер предложили исследователи Google в 2017 году в статье «Attention Is All You Need». Его главная идея — механизм внимания: модель сразу смотрит на все слова фразы и для каждого решает, какие другие слова важны для его смысла. Во фразе «девушка заплела косу» внимание свяжет «косу» с «заплела», а во фразе «косарь наточил косу» — с «наточил».
В отличие от рекуррентной сети трансформер обрабатывает всю последовательность параллельно, поэтому его быстрее обучать на огромных объёмах данных. На трансформерах построены языковые модели GPT, Gemini и Llama, а с 2020 года их применяют и к картинкам: изображение режут на небольшие квадраты и обрабатывают как последовательность «слов».
Есть и другие архитектуры. Например, генеративно-состязательные сети (GAN) и диффузионные модели умеют создавать новые изображения, а не только распознавать готовые.
Большие языковые модели и их связь с нейросетями
Большая языковая модель (LLM, large language model) — это глубокая нейросеть, чаще всего трансформер, с миллиардами параметров, обученная на огромных массивах текста. Её базовый навык прост: по началу текста предсказать следующий токен — слово или часть слова. Повторяя этот шаг снова и снова, модель пишет ответы, письма и код.
Обучение идёт в несколько этапов. Сначала предобучение: модель читает огромный корпус текстов без разметки и учится их продолжать. Такая «сырая» модель ещё плохо следует инструкциям, поэтому её дообучают на примерах диалогов и с помощью RLHF — обучения с подкреплением на отзывах людей: люди сравнивают варианты ответов, и модель учится выдавать те, что оценили выше.
Как быстро растут модели, хорошо видно по числу параметров.
60 млн
AlexNet, 2012
параметров, распознавание изображений
175 млрд
GPT-3, 2020
параметров, языковая модель OpenAI
405 млрд
Llama 3.1 405B, 2024
параметров, открытая модель Meta
Источник: Статьи и блоги разработчиков: NeurIPS 2012, OpenAI, Meta
Llama 3.1 405B обучали на более чем 15 трлн токенов с помощью более 16 тыс. графических ускорителей Nvidia H100. Её контекстное окно — 128 тыс. токенов: столько текста (запрос, файлы, предыдущая переписка) модель учитывает одновременно. Всё, что в окно не поместилось, она просто не видит.
ChatGPT, Gemini и Claude — продукты, внутри которых работают такие модели. Помимо самой модели, в чат-ботах есть поиск по интернету, работа с файлами и другие инструменты. Чем помощники отличаются на практике и какой выбрать, мы разобрали в сравнении ChatGPT, Gemini и Claude.
Связь простая: любая LLM — нейросеть, но далеко не каждая нейросеть — LLM. Сеть, которая узнаёт ваше лицо в Face ID, не пишет текстов, а чисто текстовая модель не видит картинок. Современные модели при этом всё чаще мультимодальные: Gemini, например, изначально обучали работать с текстом, изображениями, аудио и видео.
Где нейросети работают каждый день в 2026 году
В 2026 году нейросети встроены в привычные сервисы, даже если слово «ИИ» там нигде не написано. Несколько примеров с данными самих компаний и регулятора:
- Разблокировка по лицу. В Face ID блок Neural Engine превращает карту глубины лица в математическое описание, а отдельные нейросети защищают от попыток открыть iPhone маской. По данным Apple, вероятность, что телефон разблокирует случайный человек, — меньше 1 к 1 000 000.
- Перевод. Google Переводчик начал переходить на нейронный перевод в 2016 году: по данным Google, на нескольких крупных языковых парах ошибок стало на 55–85% меньше. На нейросетях работают и голосовые переводчики.
- Почта без спама. По данным Google, фильтры Gmail задерживают более 99,9% спама, фишинга и вредоносных писем. В 2019 году компания сообщила, что модели на TensorFlow добавили к ним ещё около 100 млн заблокированных писем в день.
- Пробки и время в пути. Google Карты с 2020 года прогнозируют время поездки с помощью графовых нейросетей DeepMind. По данным компании, в Берлине, Токио, Сиднее и ряде других городов прогноз стал точнее — до 50%.
- Рекомендации. Ещё в 2016 году Google описала, как рекомендации YouTube строят две глубокие нейросети: одна отбирает ролики-кандидаты из огромного каталога, другая их ранжирует.
- Поиск и чат-боты. Обзоры от ИИ в Google Поиске с мая 2025 года доступны более чем в 200 странах и территориях и на 40 с лишним языках. ChatGPT, Gemini и Claude отвечают на вопросы, пишут тексты и код.
- Картинки и музыка. Генеративные нейросети создают изображения и треки по текстовому описанию — например, музыку в Suno, Udio и Adobe Firefly.
- Медицина. В публичном списке американского регулятора FDA — более 1 600 медицинских устройств и программ с ИИ, разрешённых к продаже в США (данные по конец июня 2026 года). Около трёх четвертей из них относятся к радиологии, то есть работают со снимками.
Ограничения: ошибки, данные и энергия
Ошибки и галлюцинации
Нейросеть выдаёт самый вероятный ответ, а не проверенный. У системы распознавания это выглядит как обычная ошибка: собаку приняли за кошку. У языковых моделей — как галлюцинация: уверенный и гладкий, но выдуманный факт, цитата или ссылка.
Исследователи OpenAI в статье 2025 года объясняют это так: при обучении и в тестах модели поощряют за угаданный ответ сильнее, чем за честное «не знаю», поэтому им выгоднее угадывать. По их оценке, галлюцинации остаются даже у самых современных систем.
Цена ошибки бывает реальной. В июне 2023 года федеральный суд в Нью-Йорке оштрафовал юристов на $5 000: они подали документ со ссылками на несуществующие судебные решения, которые сочинил ChatGPT (дело Mata v. Avianca).
Данные и предвзятость
Нейросеть знает только то, что было в обучающих данных, вместе с их перекосами. В исследовании Gender Shades (MIT, 2018) три коммерческие системы определения пола по фото ошибались на светлокожих мужчинах не чаще чем в 0,8% случаев, а на темнокожих женщинах — в 20,8–34,7% случаев.
Если данных мало или они устарели, модель ошибается чаще. Знания языковой модели к тому же ограничены моментом, когда закончился сбор текстов для её обучения: о более поздних событиях она узнаёт, только если получает их через поиск в интернете или из ваших документов.
Наконец, нейросеть трудно проверить изнутри. В Anthropic признают, что модели чаще всего воспринимают как «чёрный ящик»: на входе запрос, на выходе ответ, и неясно, почему модель ответила именно так. Разбором их внутреннего устройства занимается отдельное направление — интерпретируемость.
Энергия
Обучение и работа больших моделей требуют много электричества. По оценке Международного энергетического агентства, в 2024 году дата-центры потребили около 415 ТВт·ч — примерно 1,5% мирового электричества. К 2030 году, по прогнозу агентства, их потребление вырастет более чем вдвое, примерно до 945 ТВт·ч, и главный драйвер этого роста — ИИ.
Отдельный запрос требует немного энергии. Google в августе 2025 года сообщила, что медианный текстовый запрос к Gemini расходует 0,24 Вт·ч — как телевизор, включённый меньше чем на девять секунд, — и что за 12 месяцев этот показатель снизился в 33 раза.
Краткая история нейросетей
Нейросетям больше 80 лет: идея появилась задолго до смартфонов и чат-ботов.
1943
Модель нейрона
Уоррен Мак-Каллок и Уолтер Питтс описали искусственный нейрон математически
июль 1958
Перцептрон
Сеть Фрэнка Розенблатта на компьютере IBM 704 за 50 попыток научилась отличать карточки с меткой слева и справа
1986
Обратное распространение ошибки
Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс показали в журнале Nature, как обучать многослойные сети
1997
LSTM
Описаны рекуррентные сети с «долгой краткосрочной памятью»
2012
AlexNet
Свёрточная сеть, обученная на видеокартах, выиграла конкурс ImageNet
июнь 2017
Трансформер
Исследователи Google опубликовали статью «Attention Is All You Need»
30 ноября 2022
ChatGPT
OpenAI открыла чат-бот на основе модели серии GPT-3.5
8 октября 2024
Нобелевская премия
Джону Хопфилду и Джеффри Хинтону присудили премию по физике за открытия, которые сделали возможным машинное обучение на нейросетях
Словарик: главные термины
- Нейрон — узел сети: складывает входы, умноженные на веса, и пропускает сумму через функцию активации.
- Вес — число, которое задаёт силу связи между нейронами. Именно в весах хранится всё, чему сеть научилась.
- Функция активации — нелинейное преобразование, например ReLU. Без него сеть не выучит сложные зависимости.
- Параметры — все веса и смещения модели. Их число обычно и называют размером модели.
- Функция потерь (loss) — формула, которая показывает, насколько ответ сети далёк от правильного.
- Обратное распространение ошибки — способ посчитать, как каждый вес повлиял на ошибку.
- Градиентный спуск — пошаговая подстройка весов в сторону меньшей ошибки.
- Эпоха — один полный проход по всем обучающим примерам.
- Переобучение — сеть запомнила обучающие примеры, но плохо работает на новых.
- Токен — кусочек текста (слово, часть слова или символ), с которым работает языковая модель.
- Контекстное окно — сколько токенов модель учитывает за один раз, её «рабочая память».
- Галлюцинация — правдоподобный, но ложный ответ модели.
Источники и методика
Анализ открытых источниковПроверено 29 сентября 2026
- Google Machine Learning Crash Course: нейронные сети developers.google.com
- Anthropic: глоссарий терминов LLM platform.claude.com
- Vaswani и др. «Attention Is All You Need» (2017) arxiv.org
- OpenAI: Why language models hallucinate (2025) openai.com
- МЭА: Energy and AI (2025) iea.org
Частые вопросы
Нейросеть и искусственный интеллект — это одно и то же?
Нет. Искусственный интеллект — широкая область, машинное обучение — её часть, а нейросети — один из методов машинного обучения. Именно на нейросетях работают ChatGPT, Gemini и Claude.
Нейросеть думает как человек?
Нет. Идея нейросетей навеяна устройством мозга, но искусственный нейрон — простая математическая операция. Сеть находит статистические закономерности в данных и сама не проверяет, верен ли её ответ.
Чем нейросеть отличается от обычной программы?
Обычную программу пишет человек, задавая правила. Нейросеть получает примеры и сама подбирает веса — у больших моделей их миллиарды, — поэтому справляется с задачами, для которых правила не сформулировать, например узнаёт лица и речь.
Почему ChatGPT иногда выдумывает факты?
Языковая модель предсказывает правдоподобное продолжение текста, а не ищет истину. По данным OpenAI, при обучении и в тестах модели поощряют за угадывание сильнее, чем за честное «не знаю», поэтому галлюцинации случаются даже у новых моделей.
Можно ли самому обучить нейросеть?
Да. Небольшую сеть, например для распознавания рукописных цифр MNIST, можно обучить на обычном компьютере с помощью бесплатных библиотек PyTorch или TensorFlow. Основы можно изучить по бесплатному курсу Google Machine Learning Crash Course.
Добавить комментарий